Ieri sera ho avuto il piacere di partecipare al meetup “M15 – Inference engines” organizzato da Andrea, Improove, community AI Italy, incontro tecnico molto interessante, ospiti di “casa Adesso.it”, dei sempre curiosi -nonché gentili e competenti- Stefano e Francesco.
Sala colma tipica delle grandi occasioni, materie grigie in extended mode per capirne un po’ di più, a chiedersi come si fa girare un LLM, come sfruttare al meglio memoria, GPU e banda. Lieve ansia di chi si accorge che il cofano è molto più grande (o molto più piccolo?) di quanto ricordasse. Dell’addestramento si parla spesso, ma è nell’inferenza, quando il modello genera risposte, che si gioca la partita di efficienza, scalabilità e costi. Due progetti open source, due angolazioni opposte, ma molto vicine, sullo stesso problema.
vLLM: alte prestazioni per la produzione
Presenta il collega Red Hat Daniele Zonca, con un intervento su architettura, sfide e scaling di vLLM, diventato lo standard de facto per il serving di LLM ad alto throughput, grazie a una gestione della memoria molto intelligente e allo scaling su più GPU e nodi. Se dovete portare un LLM in produzione su larga scala, partite da qui (vLLM su GitHub).
Colibrì: modelli immensi su hardware consumer
Meno noto, ma tecnicamente affascinante. Il motto è “Tiny engine, immense model“: C puro, zero dipendenze, e modelli Mixture of Experts da miliardi di parametri che girano su hardware “domestico”. VRAM, RAM e disco NVMe come un’unica gerarchia di memoria, portando dallo storage solo gli “esperti” che servono, quando servono.
Se vLLM serve il mare (l’oceano?) a migliaia di utenti, Colibrì fa entrare il mare in un bicchiere. Non a velocità da datacenter -il progetto è onestissimo su questo- ma funziona (Colibrì su GitHub).
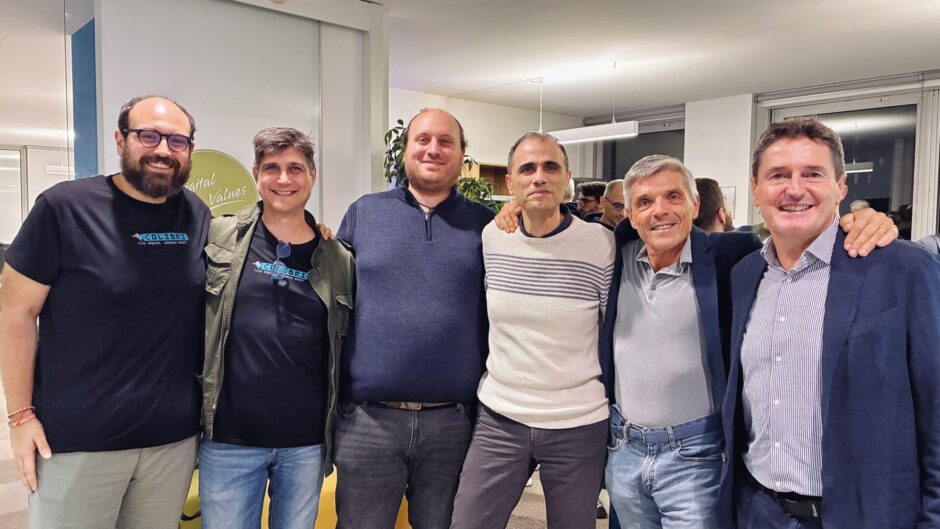
Perché approfondire
L’IA corre veloce e capire come funzionano i motori sotto il cofano è ormai una competenza chiave per architetti, sviluppatori e system engineer. Dopo l’ultima slide, tra una pizza e due chiacchiere, la parola più ricorrente era open. E non per slogan.
Aprite i link, leggete la documentazione, sporchiamoci le mani.
Scopri di più da Luca Bonesini
Abbonati per ricevere gli ultimi articoli inviati alla tua e-mail.